대규모 언어 모델 기반의 전략적 파라미터 생성을 통한 상황 적응형 군집 무인기 임무 할당

CopyrightⓒKROS
Abstract
This paper proposes a novel hybrid framework for multiple Unmanned Aerial Vehicle (UAV) task allocation that bridges the semantic gap between strategic intent and numerical control in dynamic environments. Traditional optimization algorithms often fail to adapt flexibly to unpredictable events due to their reliance on rigid, rule-based logic. To address this limitation, we introduce a hierarchical hybrid decision-making architecture that integrates Large Language Model (LLM) with the Consensus-Based Bundle Algorithm (CBBA). In this framework, the LLM serves as a strategic planner, interpreting the semantic context of dynamic events and generating high-level strategic parameters, which then guide the CBBA’s decentralized execution. Furthermore, to rigorously analyze the system’s performance, we established multi-faceted evaluation metrics encompassing mission success, time efficiency, reallocation, survivability, and resource efficiency. Simulations comparing our method against Greedy and standard CBBA algorithms demonstrate its superior strategic adaptability. The simulation results demonstrate that the proposed method exhibits human-like strategic flexibility. This study validates the LLM as an effective strategic optimizer for resilient swarm operations.
Keywords:
Multi-Robot System, Adaptive Task Allocation, Large Language Model, Semantic Gap1. 서 론
최근 인공지능과 로봇 기술의 발전으로 다수의 무인기(Unmanned Aerial Vehicle, UAV)가 군집을 이루어 협력적으로 임무를 수행하는 군집 무인기 시스템의 중요성이 국방, 재난 구조, 물류 등의 다양한 분야에서 급격히 증대되고 있다[1]. 군집 무인기 운용의 핵심은 제한된 자원을 다수의 임무에 효율적으로 분배하는 것이다. 군집 무인기 임무 할당 문제는 조합 최적화(Combinatorial Optimization)의 대표적인 NP-hard 문제[2]로 알려져 있으며, 해의 복잡도가 무인기와 임무의 수에 따라 기하급수적으로 증가하는 어려움이 있다[3]. 특히 실제 운용 환경에서는 임무 도중 신규 목표물이 발견되거나 무인기가 손실되는 등 예측 불가능한 동적 상황이 빈번히 발생하므로, 변화에 실시간으로 대응할 수 있는 임무 재할당 능력이 요구된다.
다중 에이전트의 임무 할당을 위해 널리 사용되는 시장 기반(Market-based) 분산형 합의 알고리즘인 CBBA (Consensus-Based Bundle Algorithm)[4]는 준최적성(sub-optimal)과 충돌 없는 임무 할당을 수학적으로 보장한다는 강력한 장점이 있다. 그러나 CBBA를 비롯한 수치 최적화 기법들은 사전에 정의된 규칙이나 거리, 이동 시간, 비용 등 수치화 된 정량적 데이터에만 의존하여 재계획을 수행한다. 예를 들어 규칙이나 최적화 기반의 알고리즘은 ‘무인기 3대 임무수행 불가 상태’의 상황을 무인기의 수가 -3만큼 감소하였다는 수치적 감소로만 인식할 뿐, 이것이 현장상황에서 요구하는 ‘구조 장비 역량의 임계치 도달로 인한 현장 자원의 보수적 운용 필요’와 같은 의미론적 맥락을 인지하고 유연하게 대처하는 전략적 판단 능력에 한계가 있다. 따라서, 기상 악화나 적 위협도의 변화와 같은 정성적이고 복합적인 상황 변화에 유연하게 대응하기 어렵다.
최근 이러한 의미론적 간극(Semantic Gap)을 극복하기 위해 대규모 언어 모델(Large Language Model, LLM)을 활용하여 다중 로봇 시스템에 접목하려는 시도가 폭발적으로 증가하고 있다[5]. LLM은 사전 학습된 높은 수준의 제로샷(Zero-shot) 추론과 자연어 기반의 상황 인지력을 가지지만, 군집 무인기의 임무를 할당하는 동적 환경에서 LLM 단독으로 할당할 경우 치명적인 환각(Hallucination) 현상을 일으키거나 수학적 최적성 및 분산 실행의 신뢰성을 완벽히 보장하지 못하는 문제를 겪을 수 있다.
따라서 본 논문은 기존 연구의 수치 최적화 기반 알고리즘의 전략적 유연성 부족과 LLM 기반 계획의 수학적 불완전성이라는 두 가지 한계를 상호 보완적으로 해결하는 대규모 언어 모델 기반 상황 적응형 군집 무인기 임무 할당 프레임워크(LLM-Guided CBBA)를 제안한다. 상위 계층의 LLM은 ‘상위 전략가’로 배치하여 규칙에 없는 예외 상황이나 전술적 맥락을 의미론적으로 해석해 파라미터를 동적으로 조정한다. 하위 계층에서는 다중 임무를 위한 확장형 CBBA, 검증된 분산 최적화 알고리즘으로 개별 무인기 간 자율적인 임무 협상과 실행을 담당한다.
본 연구에서 제시하는 주요 학술적 기여는 다음과 같다.
(1) 하이브리드 방식의 의사결정 프레임워크 제안
LLM에서 발생할 수 있는 환각 현상과 시스템 지연을 방지하기 위해 LLM이 매순간 개입하거나 코드를 생성하는 것이 아니라 무인기 손실이나 신규 목표물 탐지와 같은 특정 동적 이벤트가 발생하는 시점에만 선택적으로 개입한다. LLM이 상위 전략지침(목표물 우선순위, 자원 할당량 등)을 생성하면 개별 무인기들은 분산 최적화 알고리즘을 통하여 자율적으로 임무를 협상하고 수행하며, 기존 최적화 알고리즘이 제공할 수 없는 설명 가능성과 전략적 유연성을 동시에 제공한다.
(2) 다각적 분석 평가 지표 구축
군집 무인기 임무 할당 문제를 다각적으로 분석하기 위해 임무 성공률, 시간 효율성, 재할당, 생존성, 자원 효율성 상충되는 목표 간 Trade-off를 반영한 복합적인 평가지표를 도입하여 현실적 의사결정 상황을 반영한 종합적 평가 체계를 새롭게 정의하였다.
(3) 동적환경에서의 전략적 의사결정 능력검증
예측 불가능한 이벤트가 발생하는 동적환경에서 LLM이 상황의 맥락을 이해하고 전략적 파라미터를 즉각적으로 수정하는 적응성을 입증함으로써, 어려운 현실세계의 정성적이거나 수치화하기 어려운 복잡한 제약 조건을 유연하게 처리하는 방안을 제시한다.
본 논문의 구성은 다음과 같다. 2장에서는 CBBA 기반 동적 임무할당과 LLM과 최적화 알고리즘을 결합한 하이브리드 기법을 적용한 연구들을 분석한다. 3장에서는 군집 무인기 임무 할당 문제와 평가 지표를 정의하고, 4장에서는 다중 임무 할당을 위한 확장형 CBBA와 LLM 기반 하이브리드 프레임워크를 기술한다. 5장에서는 시뮬레이션 실험을 통해 성능을 비교 검증하며, 6장에서 결론을 서술한다.
2. 관련 연구
동적 환경에서의 다수의 군집 무인기 임무 할당 연구는 크게 세 갈래로 구분된다. 첫째, 최적화 알고리즘 접근법으로 초기 연구들은 다수의 무인기의 상태를 수집한 정보를 통해 중앙 노드가 전역 최적해를 계산하는 중앙 집중식 방식이었다. 대표적인 연구로는 MILP(Mixed Integer Linear Programming)[6] 알고리즘으로 이기종 다중 무인기의 임무 재할당문제를 MILP로 정식화한 연구[7]가 발표되었다. MILP 접근법의 장점으로 알고리즘 수렴 시 최적해를 수학적으로 증명할 수 있지만, 문제 규모가 커질수록 계산 복잡도가 지수적으로 증가하는 한계를 가진다. 이를 완화하기 위한 대안으로 GA (Genetic Algorithm)[8], PSO (Particle Swarm Optimization)[9] 등의 메타 휴리스틱 기법이 활용되었다. 이들은 전역 정보를 활용함에도 연산부하를 줄일 수 있었지만 전역 최적해를 보장하지 못하며, 대규모 동적 환경에서 임무 발생 속도를 따라가지 못해 실시간성이 저하되는 공통적인 문제가 있다. 이러한 중앙집중형 접근의 한계를 극복하기 위해 제안된 대표적 대안이 분산형 접근법 및 경매 알고리즘이다. CBBA는 각 무인기가 지역적 정보만으로 임무 번들을 구성하고, 인접 노드 간 합의를 통해 충돌 없는 전역 할당을 달성한다. 따라서 중앙집중형 기법 대비 대규모 군집 운용에 훨씬 적합하다는 평가를 받으며 다수의 변형 연구로 이어졌다. 신규 타겟 출현이나 기체 손실 등 동적 상황 발생 시 전체 재계획 없이 일부 임무만 부분적으로 재계획하여 연산시간을 단축하는 CBBA-PR (Partial Replanning)[10]과 무인기-임무 간 수행 가능 관계를 행렬로 표현해 영향 구역을 설정하여 재계획 범위를 최소화하는 CBBA-LR (Local Replanning)[11] 기법 등이 대표적이다. 이러한 연구들은 통신 효율과 재계획 속도 개선을 통해 CBBA의 확장성을 높이는 데 주된 목표를 두지만, 할당의 기준이 되는 목적함수와 가중치 자체는 사전에 정의되어 있어, 동일한 이벤트가 발생해도 그 상황이 갖는 의미에 따라 전략을 달리 가져가는 데에는 한계가 있으며 지역 최적해에 빠질 수 있다.
두 번째로, 실시간성이 요구되는 대규모 군집 운용 환경에서 수식 기반 계산의 한계로 데이터 기반의 학습 알고리즘들이 연구되고 있다. 에이전트가 환경과의 상호작용을 통해 최적의 정책을 사전 학습하는 MARL (Multi-Agent Reinforcement Learning) 구조가 대표적이며 이기종 무인기 협업 동적 임무 할당문제를 MARL로 해결한 연구[12] 등 학습 단계에서 방대한 시나리오를 경험한 무인기들이 실전에서 빠른 추론 속도로 임무를 자율 분배하도록 하는 연구들이 진행되고 있다. 하지만, 학습 기반 접근법에는 학습에 필요한 방대한 시뮬레이션 및 데이터가 요구되고 학습된 정책이 학습한 분포를 벗어난 새로운 상황에서 일반화가 어렵다는 단점이 있다.
세 번째로 LLM과 최적화 알고리즘의 결합을 통한 하이브리드 접근법이다. LLM은 사전 학습된 자연어 이해 능력을 통해 인간의 고수준 의도나 전술적 의도를 파악할 수 있다. 하지만 LLM을 단독으로 사용하여 제어 코드나 행동 계획을 직접 생성하는 방식은 물리적으로 불가능한 계획을 세우거나 환각(Hallucination) 현상을 일으켜, 동적 환경에서 수학적 최적성 및 분산 실행의 신뢰성을 완벽히 보장하지 못하는 문제를 겪을 수 있다. 이를 보완하기 위해 LLM을 기존 최적화 알고리즘과 결합하는 하이브리드 접근이 제안되고 있다. 본 연구와 접근 철학이 유사한 두 가지 최신 연구를 확인하였다. 먼저, LLM과 GA가 결합된 LLMGA[13]는 다중 무인기 임무할당 문제를 수학적 계산은 GA를 통해, LLM은 전체 진화 과정을 살피며 교차율이나 변이율 등의 파라미터를 실시간으로 튜닝하며 수렴 성능을 높였다. 본 연구와는 무인기 임무 할당 문제에서 GA의 교차율이나 변이율 등의 파라미터를 생성하는 것에서 유사한 점이 있지만, 이는 오직 GA의 수렴을 위함이다. 본 연구에서는 동적 이벤트 시점에 선택적으로 LLM이 하위 CBBA 전술 실행기의 파라미터를 생성하며 임무할당 과정에 적극적으로 개입한다. 무인기 간 수렴성을 CBBA가 보장하고, 수치적으로 표현되지 않는 전략적 맥락의 해석을 LLM이 담당한다. 다음 최신 연구로 우주탐사 환경에서 LLM과 CBBA를 결합한 KG-CBBA[14] 연구가 있다. CBBA의 입찰함수를 지식그래프 KG (Knowledge Graph) 형태로 제약조건을 구조화하고 LLM은 새로운 임무 정보를 사람의 개입 하에 생성하는 역할을 담당한다. 본 연구와의 차이점은 KG-CBBA는 LLM의 개입이 우주비행사의 질의에서부터 시작되는 human-in-the-loop 구조이며, 입찰 함수는 KG 기반으로 고정되어 설계되고 LLM은 입력 데이터를 생성할 뿐, 가중치 등의 전략적 파라미터를 재생성하지는 않는다.
3. 문제 정의
3.1 군집 무인기 임무할당 문제 정의
본 연구에서 다루는 군집 무인기 임무 할당 문제는 다수의 무인기와 목표물(Target)로 구성된다. 무인기의 종류는 고정익 무인기로, 무인기의 임무를 수행하는 임무 실행 기체와 전체적인 상황을 지켜보는 관측 기체로 구분된다. 실행기와 관측기는 시나리오마다 그 수가 무작위로 선정된다. 관측기는 실행기가 임무를 완수하였는지 관찰하며 무인기 군집에 임무 실행 기체가 더 이상 남아있지 않을 경우, 관측기체가 실행기의 임무를 수행할 수 있도록 한다. 본 연구에서는 군집 무인기의 임무를 특정 목표물에 긴급 구호 물품을 전달하는 것으로 정의한다. 각 기체는 예측 불가능한 동적 환경을 극복하고 목표 위치에 도달해야 하며, 도달 시 현장의 지형적 불확실성을 고려하여 50 %의 확률로 최종 전달에 성공하는 확률적 임무 모델을 적용한다. 만약 최종 전달 과정에서 불확실성 임계치를 초과할 경우, 기체는 복잡한 지형 지물과의 충돌로 인해 임무 불가능 상태가 되는 상황을 가정한다.
본 연구에서 다루는 군집 무인기 임무 할당 문제는 2차원 공간 상의 작전 지역 내에서 다수의 무인기와 목표물로 구성된 환경을 가정한다. 전체 무인기의 집합은 U = {U1, … Ui, UN}으로, 목표물의 집합은 T = {T1, …, Tj, TM}으로 정의하며, 각 목표물은 임무 중요도(Value)에 따라 서로 다른 가중치를 가진다. 각 무인기와 목표물은 물리적 속성으로 고유의 이동 속도 Vi, Vj를 가지며, 무인기는 제한된 시간 tmax 내에 할당된 목표물에게 긴급 구호 물품을 전달해야 한다.
동적 임무 할당 문제의 핵심은 초기 계획 수립 이후 발생하는 예측 불가능한 상황 변화에 대응하는 것이다. 본 연구에서 시뮬레이션 도중 발생하는 동적 이벤트를 두 가지 유형으로 정의한다. 첫째는 무인기 자산의 손실로 작전 수행 중 무작위로 일부 무인기가 임무 수행 불가 상태가 되는 상황이다. 둘째로 임무 도중 새로운 목표물이 추가로 탐지되는 상황을 가정한다. 이러한 이벤트가 발생할 때마다 그리고 시나리오 시작시점에 각 알고리즘은 잔여 무인기와 목표물의 정보를 바탕으로 실시간 재할당을 수행해야 한다.
3.2 임무 성능 평가 지표
본 연구의 군집 무인기 임무 할당 문제는 정적인 1회성 최적화가 아닌, 예측 불가능한 동적 이벤트가 발생하는 시점 t마다 실시간으로 재계획을 수행하는 문제로 정의된다. 따라서 특정 이벤트 발생 시점 t에서의 목적 함수는 다음과 같다.
| (1) |
여기서 U(t)와 T(t)는 시점 t에서의 가용 무인기 집합과 목표물 집합을 의미한다. 동적 환경의 특성상 작전 중 무인기 임무 불가능 상황이 발생할 수 있으므로 U(t)는 초기 무인기 집합의 부분집합 U(t) ⊆ U(0)이 된다. 성공적으로 임무를 완수한(Completed) 목표물을 Tc로 정의할 때, 신규 목표물이 추가 탐지될 수 있으므로 T(t)는 초기 목표물 집합을 포함하는 확장 가능한 가변 집합 T(0) ⊆ T(t) ∪ Tc(t)로 정의된다. 이벤트 시점 t마다 업데이트되는 환경 변수 U(t)와 T(t)를 반영하여 임무의 다면적 성과를 종합적으로 평가하는 종합 임무 성과 점수 STotal를 최대화하는 것으로 알고리즘의 임무 성능을 평가한다.
식 (2)의 STotal은 최대 100점으로 정규화 되며, 각 세부 평가지표들의 가중합으로 정의된다. 각 세부 가중치는 k로 표현되며 임무 성공률, 시간 효율성, 재할당률, 생존성, 자원 효율성 5가지 세부 지표를 포함한다. 각 지표를 나타내는 k의 범위는 다음과 같다.
k ∈ {Success, Time, Reallocation, Survivability, Resource}
wk는 각 지표의 가중치를 의미하고 본 연구에서는 모든 지표를 동등하게 평가하기 위해 ∑wk = 100의 제약조건 하에 wk = 20으로 설정하였다. Sk는 0과 1 사이의 값으로 Sk ∈ [0,1] 정규화한 점수를 나타낸다.
| (2) |
전체 할당된 목표물 중 성공적으로 임무를 완수한 목표물 Tc의 비율로서, 시간을 제외하고 중요 표적에 대한 임무 성공 점수를 평가한다. 목표물에 대한 임무 수행을 하나도 달성하지 못하면 0점, 모든 목표물의 임무 완수 시 최대 1점을 받는다.
| (3) |
식 (3)에서의 I는 목표물의 중요도 가치(Importance)로서 Ic는 완료된 목표물의 중요도를 Ij는 개별 목표물 j에 부여된 가중치를 의미한다. 따라서 단순한 임무 성공의 비율이 아닌 목표물의 가치를 고려하여 임무를 성공적으로 완수한 목표물의 가치 총합을 전체 목표물의 가치로 나눈 비율로 임무 성공 점수를 산정한다.
주어진 임무 제한시간 tmax 대비 얼마나 빠르게 임무를 완수했는지를 평가한다. 임무 종료 시점 t가 빠를수록 높은 점수를 부여하고 임무를 끝내지 못하면 0점을 받는다. 초기 1점부터 시작하여 시간이 지남에 따라 계속 점수가 감소한다. 단, 임무 종료 시점 t는 주어진 임무 제한시간 tmax를 초과할 수 없다.
| (4) |
재할당 점수는 동적 이벤트 발생 전후에 무인기 군집의 임무 할당 계획이 얼마나 변경되었는지를 나타내는 점수이며, 실시간으로 변화하는 환경에 얼마나 빨리 반응하고 적응할 수 있는지를 나타내는 지표이다. 임무 계획의 변화량을 정량화하기 위해 집합 간의 유사도를 측정하는 자카드 지수(Jaccard Index)[15]를 활용한다. 두 집합 간 자카드 유사도 ℐ는 다음과 같이 정의된다.
| (5) |
여기서 ℐ가 1에 가까울수록 계획의 변화가 없음을 의미한다. 환경 적응성을 평가하기 위해, 유사도의 비유사도(Dissimilarity)인 자카드 거리(Jaccard Distance, 1-ℐ)를 적용하여, 기존 계획과 달라진 정도를 점수화하였다.
| (6) |
식 (6)에서 t 시점에 가용 무인기의 집합 U(t)는 수식의 분모에 위치하여 생존한 무인기 수만큼의 평균적인 변화량을 측정한다. Ti(t)는 시점 t에서 무인기 i에게 할당된 목표물 리스트로서 식 (5)의 ℐ(A, B) 자카드 유사도 (0~1)를 통해 측정된다. 자카드 유사도의 비유사도인 자카드 거리를 사용하여, 예측 불가능한 상황에서 자원을 재분배하는 알고리즘의 유연성과 적응력을 정량화 할 수 있도록 해당 지표를 설계하였다.
생존성 점수는 알고리즘이 얼마나 안전한 전략을 택했는지 평가한다. 특정 시점 t에 아무 무인기도 가용할 수 없다면 0점, 최소한의 무인기만 사용 시 1점을 받는다.
| (7) |
식 (7)의 U(t)는 특정 시점에 가용 무인기의 집합을 나타낸다. 또한 T(t)는 특정 시점에 임무 미완수 목표물의 집합을 의미한다. 이때 극단적인 자원 부족 상황에서 분모가 음수나 0이 되는 연산 오류를 방지하기 위해 |U(0)| ≤ |T(t)|인 경우 분모는 |U(0)|만을 사용한다. 점수의 상한을 위해 min 함수를 적용하였다. 임무 미완수 목표물 대비 운용 가능한 무인기의 비율을 계산하여 알고리즘의 보수적 운용 능력을 평가한다.
필요 이상으로 많은 무인기를 할당하는 ‘과잉할당’ 또는 부족하게 할당하는 ‘과소 할당’의 비율을 측정하여 자원 효율성을 평가한다. 목표물의 중요도가 높아짐에 따라 최적 자원의 무인기 수가 많아지도록 설정하였다. 최적 자원 수에 맞추어 효율적으로 자원을 사용한다면 최대 1점, 비효율적인 자원 사용에 대해 0점까지 페널티를 부과한다.
| (8) |
식 (8)의 Uj는 목표물 j의 임무를 수행하기 위해 할당된(Assigned) 무인기들의 집합을 의미하며, |Uj|는 그 할당된 무인기의 총 대수를 나타낸다. 임무 완수에 필요한 최적의(Optimal) 무인기 대수인 |Uj*|은 개별 목표물에 부여된 중요도 Ij의 중간 값을 올림한 수치로 계산하며, 수치가 1보다 작을 경우 시스템상 최소 1대의 무인기가 할당되도록 하한선을 두었다. 임무 완수 시 최적의 무인기 필요량 |Uj*|에서 실제 투입량 |Uj|의 차이를 계산하여 과잉 또는 과소 할당된 자원의 비율만큼 페널티를 부과함으로써 자원 운용의 효율성을 평가한다.
군집 무인기 동적 임무할당 문제 정의에서 시뮬레이션 환경, 예기치 못한 동적 이벤트, 그리고 다면적 성과 측정 지표를 체계적으로 정의하여, 다양한 조건 하에서 무인기 할당 알고리즘의 장단점을 명확하게 비교하고 분석할 수 있도록 각 평가지표를 설계하였다.
4. 제안 프레임워크
4.1 다중 할당을 위한 확장형 CBBA
본 연구에서는 군집 무인기의 분산형 임무 할당을 위한 기반 알고리즘으로 CBBA를 채택하였다. CBBA는 분산형 경매 기반의 알고리즘으로, 에이전트 간의 부분적인 통신만으로도 충돌 없는 전역적 임무 할당을 다항 시간 내에 보장하는 장점이 있다. 특히 무인기 손실 상황에서 유연하게 대처할 수 있어, 예측 불가능한 동적 전장 환경에 매우 적합하다. 하지만 CBBA는 본질적으로 하나의 임무는 오직 하나의 에이전트에 의해서만 수행될 수 있다는 1:1 할당 제약 조건을 갖는다. 따라서 여러 대의 무인기가 하나의 목표물에 동시 배정될 수 있도록 CBBA의 합의 규칙을 확장하여 다음과 같이 알고리즘을 변형하였다.
- (1) 임무별 할당 쿼터(Quota) 도입: 각 임무별로 목표 달성에 필요한 무인기의 수(최대 할당 가능 대수)를 의미하는 할당 쿼터 개념을 새롭게 도입하였다.
- (2) 승자 목록 크기 확장: 기존 CBBA가 각 임무당 단 1명의 승자(Winner) 정보만 유지했던 것과 달리, 변형된 알고리즘에서는 임무별로 쿼터 크기만큼의 승자 목록을 유지할 수 있도록 구조를 확장하였다.
- (3) 갈등 해결 메커니즘 변경: 합의 단계에서 무인기들이 입찰가를 교환할 때, 단일 최고 입찰자만 남기는 기존 방식 대신 입찰 점수를 정렬하여 상위 쿼터 수의 무인기들을 모두 승자로 인정하도록 갈등 해결 규칙을 변경하였다. 만약 새로운 입찰로 인해 승자 목록에서 밀려난 무인기는 해당 임무에 대한 할당을 즉시 해제하고, 차선책 임무를 탐색하여 다시 입찰을 시도하게 된다.
이러한 확장을 통해 변형된 CBBA는 특유의 분산형 합의 메커니즘과 강건성을 유지하면서도, 하나의 중요한 목표물에 다수의 무인기를 유연하게 집중시키는 전략적 임무 할당이 가능해진다.
본 연구에서 개별 무인기 i가 특정 시점 t에 목표물 j에 대해 산출하는 기본 입찰 점수의 행렬은 식 (9)와 같이 정의한다.
| (9) |
여기서 dij는 무인기 i와 목표물 j간의 유클리디안 거리로 임무 수행에 따른 비용 요소를 나타내며, α는 거리 반비례 스케일링 상수, ε은 분모 오차 방지를 위한 미소 상수이다. Ij는 목표물 j에 사전 부여된 목표물의 임무 중요도이다. 이후 괄호 파트는 시간 경과에 따른 목표물별 임무 중요도에 따른 긴급도 가중치이다. β는 임무의 시급성을 반영하기 위한 가중치 스케일링 상수이다. 긴급도 가중치는 시뮬레이션 초기에는 정적으로 가중치를 가지지만, 시간이 경과함에 따라 중요도 Ij에 비례하여 선형적으로 가속된다. 이를 통해 자원이 제약된 상황에서 무인기들이 고가치 표적으로 집중하도록 유도하였다.
4.2 LLM 기반 하이브리드 의사결정 프레임워크
본 연구에서 제안 프레임워크는 무인기 동적할당 문제의 특성에 따라 LLM의 추론 능력을 활용하여 동적 환경에 유연하게 대응하는 군집 무인기 임무 할당 프레임워크를 제안한다. 제안하는 프레임워크는 상위 레벨의 전략적 추론과 하위 레벨의 수학적 최적화가 결합된 계층적 구조를 가진다. 이 프레임워크는 자연어로 기술된 전술적 상황과 수치화 된 시스템 제어 변수 사이의 의미론적 간극을 해소하여, 예측 불가능한 동적 환경에서도 빠르게 적응하여 유연하게 임무를 할당할 수 있도록 설계되었다.
[Fig. 1]은 제안하는 프레임워크의 전체적인 데이터 흐름과 계층 구조를 나타낸다. 시스템의 최상위 계층에는 대규모 언어 모델(LLM)이 ‘전략 계획가(Strategic Planner)’로 위치하여, 실시간으로 입력되는 상황의 맥락을 이해하고 거시적인 전략 지침을 수립한다. LLM은 ‘현장 자원의 보수적 운용 필요’나 ‘핵심 목표물의 우선 구조 수행’과 같은 추상적인 상황 정보를 분석하여, 목표물 별 중요도(Importance), 필요 자원 할당량(Quota), 상황 판단의 논리적 추론 근거(Reasoning)의 구체적인 파라미터를 JSON 형식으로 생성한다. 생성된 파라미터는 하위 레벨의 할당 전술 실행기(Tactical Executor) CBBA알고리즘에 전달되어 입찰(Bidding) 및 합의(Consensus) 단계를 거쳐 최종적인 무인기-임무 할당을 수행한다.
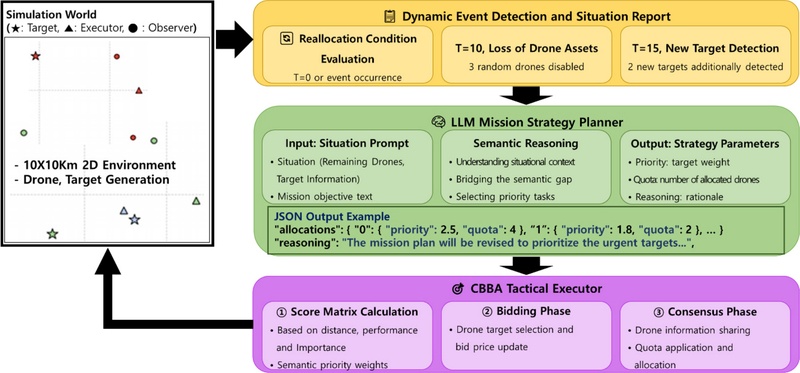
A framework for swarm UAV task allocation using LLM and CBBA hybrid algorithms
이러한 하이브리드 접근법은 LLM 단일의 임무할당에서 발생할 수 있는 환각 현상을 억제하면서도 기존 최적화 알고리즘이 갖지 못한 상황 인지 능력을 보완한다. 전체적인 시스템의 동적 대응 및 재할당 메커니즘은 다음과 같은 [Fig. 1]과 같이 3단계로 이루어진다.
- (1) 이벤트 감지 및 보고: 시뮬레이션 중 ‘무인기 3기 임무수행 불가’와 같은 이벤트가 발생하면, 현재상황의 정보(무인기와 목표물 정보, 이벤트 발생 내용)가 포함된 새로운 프롬프트가 즉시 생성되어 LLM에 보고된다.
- (2) 전략 수정 및 지침 하달: AI 임무 결정권자로 역할을 부여받은 LLM은 보고된 내용을 바탕으로 수정된 전략적 파라미터(목표물 별 무인기 할당량, 목표물의 가중치, 추론근거)를 생성하여 하위 계층에 하달한다. 아래의 프롬프트와 추론구조를 통해 전략적 파라미터를 생성한다.
- - 입력 데이터: 가용 무인기 수, ID, 위치, 현재 임무 수행 상태, 목표물의 ID, 위치, 중요도, 동적 이벤트의 발생 리포트
- - 역할 및 페르소나 부여: 당신은 군집 무인기 임무 통제관이다. 주어진 상황을 분석하여 임무목표에 맞는 임무 할당 파라미터를 결정하라.
- - 전술적 규칙: 우선순위가 높은 목표물 우선 임무수행, 이벤트 발생 시 임무 수정 및 전략 재구성
- - 구조화된 출력: 다음 형식의 JSON으로만 답변 {“Reasoning”, allocations{"Importance_weight”, "target_quota" }}
- (3) 지침 기반 분산 재할당: 무인기 군집은 새롭게 하달된 전략 지침(파라미터)을 자신의 CBBA 입찰 점수 계산 수식에 즉시 반영한다. 상위 계층인 LLM이 상황 맥락을 의미론적으로 해석하여 하달한 목표물별 전술 가중치 w_LLMj는 하위 계층의 기본 입찰 점수 함수 식 (9)에 스칼라 곱 형태로 결합하여 식 (10)과 같이 최종 입찰 점수의 행렬을 구성한다.
(10)
이렇게 계산된 최종 입찰 점수의 행렬에서 목표물별 임무가 가능한 무인기들을 정렬한 뒤 LLM이 할당한 할당량을 바탕으로 최종 입찰 승자들의 집합을 확정한다. 따라서 LLM의 전략적 의도가 반영된 점수 규칙 하에서 CBBA의 분산 합의 과정을 통해 신속하게 임무를 재분배함으로써, 변화된 상황에 의사결정권자의 전략적 의도가 반영된 대응을 수행한다.
5. 시뮬레이션 결과
5.1 시뮬레이션 구성
본 연구에서 제안하는 LLM 기반 동적 임무 할당 프레임워크의 성능을 검증하기 위해, 시뮬레이션의 환경을 구축하고 다양한 조건에서 실험을 수행하였다. 객관적 성능 평가를 위해 각 시나리오별 100회의 시뮬레이션을 적용하며, 추론 모델의 신뢰성을 검증하는 과정을 선행하였다.
시뮬레이션은 10 × 10 km2의 2차원 공간에서 총 50 스텝 동안 수행된다. 무인기의 수(N)는 시나리오에 따라 5~75기, 목표물의 수(M)는 5~15개 범위에서 무작위로 설정되었으며, 각 목표물의 중요도는 1~5 사이의 값을 가진다. 시뮬레이션의 환경은 목표물이 추가 탐지되기 이전 완전 관측(Full Observation)의 환경을 가정한다. 이때 목표물의 중요도에 따라 부여되는 임무 완수 시 최적의 무인기 필요량은 앞서 정의한 바와 같이 목표물의 중요도의 중간 값을 올림하여 최소 1대에서 최대 3대까지 최적의 무인기 필요량을 정의하였다. 무인기와 목표물의 이동 속도는 각각 180~250km/h와 50~80km/h로 설정하여 동적인 환경을 모사하였다. 무인기는 목표물을 향해 직선 경로로 비행하며, 목표물에 도달하면 원선회를 하며 임무 실행을 대기한다. 또한 알고리즘의 실시간 적응성을 검증하기 위해 두 가지 동적 이벤트를 정의하였다. t=10 시점에는 무작위로 선정된 무인기 3기가 임무 수행 불가 상태가 되며, t=15 시점에는 2개의 신규 목표물이 추가 탐지된다. 환경적 불확실성을 반영하여 모든 무인기의 임무 성공 확률은 50%로 설정하였다. 각 알고리즘들은 시나리오 시작시점과 이벤트 발생시점에 잔여 무인기와 목표물의 정보를 바탕으로 실시간 재계획을 수행한다.
본 프레임워크의 핵심인 전략적 파라미터 생성의 신뢰성을 확보하기 위해, 다양한 규모의 LLM 모델에 대한 비교 검증을 수행하였다. 초기 실험 결과, 3B 이하의 소형 언어 모델(sLLM)들은 복잡한 전략적 지시를 이해하지 못하거나 JSON 형식을 준수하지 못하고 무인기 ID를 누락(None 값 반환)하는 등 잦은 환각 현상을 보였다. 이에 본 연구에서는 안정적인 추론 능력과 정해진 출력 형식(Format) 준수 능력을 확보하기 위해 7B 이상의 모델들을 후보군으로 선정하였다. Ollama 환경과 API를 활용하여 Ministral-3:8b[16], DeepSeek-R1:8b[17], Qwen3:8b[18], Llama-3.1:8b[19], Gemini-2.5-Flash[20]을 비교 분석하였다. 위의 LLM들을 대상으로 100회의 무작위 전장 시나리오 기반 사전 성능 평가를 수행하였다. 단일 알고리즘의 환경적 편차를 배제하고자 Greedy와 CBBA를 포함한 베이스라인 평균 점수 대비 상대적 성능 향상폭 Margin을 산출하여 비교하였다. 실험 결과, Llama-3.1:8b 모델이 베이스라인 평균 점수 대비 +2.87의 성능을 기록하며 가장 우수한 전술적 임무 달성도를 나타낸 것으로 측정되었다. 이후 Gemini-2.5-Flash가 +1.04으로 그 뒤를 이었으며, DeepSeek-R1:8b (+0.55), Qwen3:8b (+0.15), Ministral-3:8b (-0.44) 모델군은 베이스라인과 유사하거나 한계효용 수준의 미미한 향상만을 보여주었다. 결과적으로 Llama-3.1:8b 모델이 전술적 상황에 대한 맥락 이해도가 가장 우수한 결과를 보였다. 전체 점수가 안정적으로 높게 측정되었을 뿐만 아니라 시스템이 요구하는 JSON 포맷의 파라미터를 오류 없이 일관되게 생성하는 것을 확인하였다.
연구의 실험환경인 RTX 3060 GPU 기준에서 Llama-3.1:8b의 추론 속도는 대략 20 tokens/s 이상의 속도로 토큰을 생성하는 준수한 성능을 보였다. 이 결과로 동적 상황 변화에 대응하여 실시간 이벤트가 발생 시 즉각적인 개입이 가능하여 시스템의 병목 현상은 발생하지 않았음을 확인하였다. 따라서 본 연구의 제안 프레임워크에는 Llama-3.1:8b를 기본 추론 엔진으로 탑재하였다.
본 연구에서는 제안하는 LLM 기반 동적 임무 할당 프레임워크의 성능을 검증하기 위해, 실험 시나리오는 무인기와 목표물의 비율에 따른 두 가지 시나리오에서 시뮬레이션 실험을 수행하였다. 통계적 유의성을 확보하기 위해 각 시나리오별 100회의 독립적인 시뮬레이션을 수행하였다. 실험 시나리오는 (1) 무인기의 수가 목표물보다 많은 자원이 풍부한 시나리오와, (2) 목표물의 수가 무인기보다 많은 자원 부족 시나리오로 구분된다.
제안 기법의 동적 대응 능력을 평가하기 위해, 단순한 규칙 기반의 접근법인 Greedy 알고리즘과 경매과정을 모방한 대표적인 분산형 합의 알고리즘인 CBBA를 다중 임무를 위한 확장형 알고리즘으로 수정하여 비교 알고리즘으로 선정하였다.
5.2 시나리오 1: 무인기의 수가 많은 환경
첫 번째 시나리오는 무인기의 수가 목표물보다 3~5배 많은 자원이 풍부한 환경이다. 무인기의 임무 성공률이 50 % 이기 때문에 이 상황에서는 목표물에 할당된 모든 임무를 처리하는 것은 기본이며, 잉여 자원을 얼마나 효율적으로 운용하여 비행 비용을 최소화하고 시스템의 안전성을 확보하는지가 핵심이다.
실험 결과, 제안하는 기법은 생존성 점수와 각 평가지표들을 합산한 전체 임무 성능 점수에서 다른 알고리즘 대비 우수한 성과를 기록했다. [Fig. 2]는 100회의 시뮬레이션 결과를 시각화한 전체 점수의 총합인 임무 성능과 자원효율성 점수이다. 전체 임무 성능의 평균 점수(STotal)에서 제안하는 프레임워크는 70.57점으로, CBBA(67.16점), Greedy(68.25점)를 상회하였다. 이는 수적 우위 상황에서 우선순위가 높은 목표물에 적절한 자원을 배분하여 전체 시스템의 안정성을 확보하였음을 시사한다.
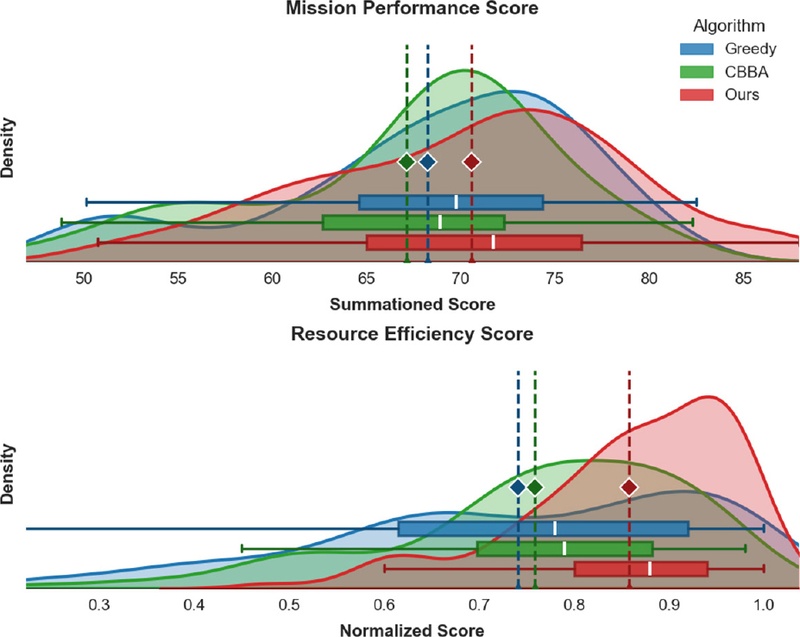
Results of total Mission Performance Score (Top) and Resource Efficiency Score (Bottom) in scenarios with a high UAV-to-target ratio (Blue: Greedy, Green: CBBA, Red: Ours)
특히 평가지표 점수 중 다른 알고리즘 대비 가장 우수한 점수는 자원 효율성 점수(SResource)이다. 자원이 풍부한 상황에서는 목표물에 불필요한 과잉 할당이 발생하기 쉬우나, 비교 알고리즘들의 평균인 0.75점 대비 제안 기법은 0.86점의 높은 효율성을 기록하여 비교 알고리즘 대비 약 14%의 유의미한 성능 향상을 보였다. 자원이 풍부함에도 불구하고 높은 재할당률을 보인 것은 시스템이 단순히 ‘남는 무인기’를 할당하는 것을 넘어, 실시간 상황 변화에 맞춰 우선순위가 높은 목표물에게 가장 적합한 무인기들을 유연하게 배치했음을 의미한다. 결과적으로 각 무인기의 위치와 임무를 수행하는데 목표물의 우선순위를 고려한 최적 매칭이 이루어지며 높은 자원 할당 점수를 달성하였다.
[Table 1]에서는 무인기가 많은 시나리오에서 100회의 무작위 동적 시나리오에서 알고리즘 별 세부 평균 점수와 모든 지표를 종합한 총합 점수를 나타낸다.

Comparison of average algorithm scores across experiments in scenarios with a high UAV-to-target ratio
표에서 나타내는 임무 성공률 지표는 무인기가 3~5배 많은 상황에서 항상 모든 임무를 성공할 확률이 매우 높다. 따라서 임무 성공률 지표는 모든 알고리즘에서 1에 가까운 점수가 나온 것을 확인할 수 있다.
제안 프레임워크는 모든 지표를 종합한 총점에서 가장 뛰어난 성능을 달성했다. 특히 임무의 중요성에 따라 무인기를 효율적으로 분배하는 자원 효율성 점수와 실시간으로 변화하는 환경에 얼마나 빨리 반응하고 적응할 수 있는지를 나타내는 지표인 재할당 점수, 무인기가 얼마나 많이 생존했는지를 나타내는 생존성 점수 측면에서 기존 Greedy와 CBBA 알고리즘 대비 강점을 보였다.
5.3 시나리오 2: 무인기의 수가 부족한 환경
두 번째 시나리오는 목표물의 수가 무인기의 가용 범위를 초과하는 자원 제약상황이다. 무인기의 임무 성공률이 50 %인 상황에서 무인기의 수가 목표물 수 대비 1~2배 인 상황이다. 이 상황에서의 핵심은 모든 임무를 완수하기 어려운 상황이기 때문에 제한된 자원을 활용하여 전체 임무의 가치를 얼마나 극대화할 수 있는가에 있다. 이 환경에서 제안하는 프레임워크는 한정된 자원으로 최대의 효과를 내기 위해 사람의 전략과 유사한 ‘선택과 집중’ 전략을 구사하였다.
자원 부족 환경에서 가장 두드러진 지표는 자원 효율성이었다. [Fig. 3]은 자원 부족상황에서 100회의 시뮬레이션 실험 결과를 시각화한 재할당, 자원 효율성 지표이다.
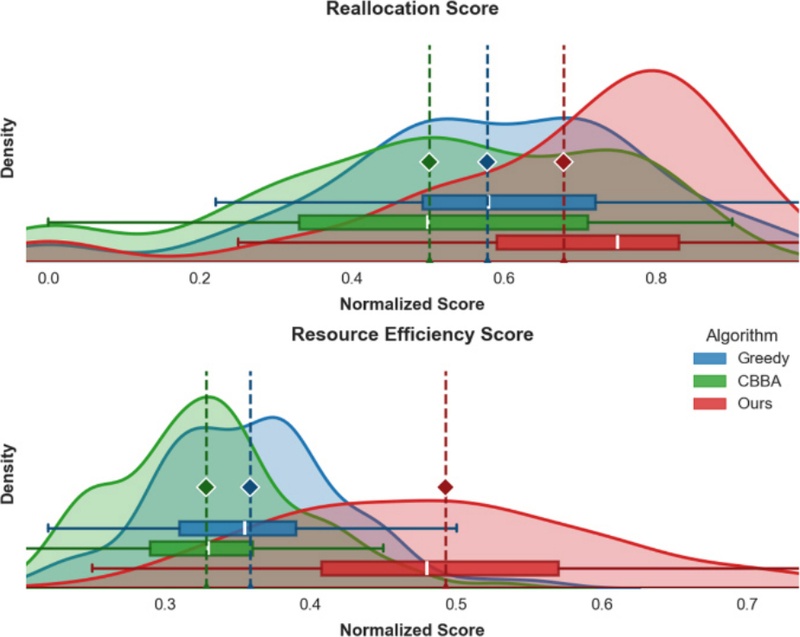
Results of Reallocation Score (Top) and Resource Efficiency Score (Bottom) in scenarios with a low UAV-to-target ratio (Blue: Greedy, Green: CBBA, Red: Ours)
재할당 평균 점수는 제안 프레임워크와 CBBA, Greedy 알고리즘 순으로 각각, 0.68, 0.5, 0.58 으로, 자원 효율성 평균 점수는 0.49, 0.33, 0.36 점으로 제안 프레임워크가 가장 우수한 결과를 나타냈다. LLM은 제한된 자원으로 중요도가 높은 목표물을 우선적으로 배송할 수 있도록 목표물 할당 쿼터 파라미터를 조정하였다. 이는 잉여 자원의 무분별한 부족 또는 과잉 할당을 차단하여 자원효율성을 높인다. 제안 프레임워크는 모든 임무 목표물을 완수하려다 전력이 분산되는 기존 방식과 달리, 초기 할당 이후에도 새로운 고우선순위 목표물이 탐지되거나 임무 상황이 변할 때마다 즉각적으로 임무를 재조정하여 LLM이 임무 시급성과 중요도에 따라 우선순위를 매기고, 무인기 1기당 처리 가능한 임무 가치를 극대화하는 방향으로 유도함으로써 재할당 점수를 향상시켰다.
자원이 부족한 상황에서는 모든 목표물에게 배송하는 것이 불가능하므로, ‘무엇을 포기하고 무엇을 취할 것인가’에 대한 의사결정이 전체 성능을 좌우한다. 실험 결과, 제안하는 기법은 단순 목표물 임무 완수 개수를 넘어선 가중치 기반의 임무 완수 점수와 전체 임무 성능에서 우수한 성과를 기록하였다.
[Fig. 4]는 자원 부족상황에서 100회의 시뮬레이션 실험 결과에 대해 자원 효율성(SResource, X축)과 임무 성공 점수(Ssuccess, Y축)의 상관관계를 나타낸 그래프이다. X, Y의 값이 모두 클수록 자원효율성과 임무 성능 점수의 균형을 맞추며 전체 성능 점수와 자원효율성 점수에서 높은 성능을 나타냄을 의미한다. 각 점은 100회의 시뮬레이션에서 기록된 점수의 결과를 나타내고, 데이터의 분포와 집중도를 시각적으로 파악하기 위해 각 알고리즘별로 데이터 밀도를 등고선으로 표현하였다. 등고선의 중심에 가까울수록 해당 성능 구간에 시뮬레이션 결과가 더 많이 집중되어 있음을 나타낸다. 비교 알고리즘인 Greedy와 CBBA는 대부분 자원 효율성 점수가 0.2~0.5점 사이에 밀집되어 있다. 이는 기존 알고리즘들이 자원 제약 상황에서 목표물의 우선순위를 고려하지 않고 가용 무인기를 과소 할당하는 경향이 있음을 시각적으로 보여준다.
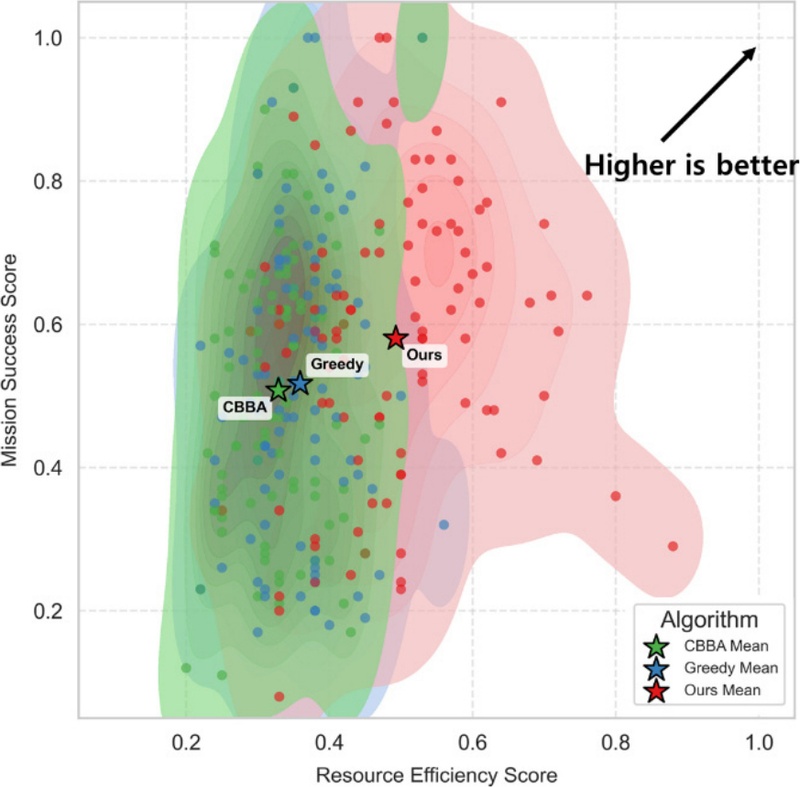
Correlation between resource efficiency scores and mission success scores in scenarios with a low UAV-to-target ratio (Blue: Greedy, Green: CBBA, Red: Ours)
반면, 제안하는 프레임워크는 X축 0.5 이상의 데이터가 넓게 분포되어 있는 것을 확인할 수 있다. 이는 제안 프레임워크가 높은 임무 성공률을 유지함과 동시에 유의미한 자원 효율성을 확보한 것을 확인할 수 있다.
데이터 분포의 중심을 살펴보면, 비교 알고리즘들은 저효율 영역에 한정된 분포를 보이지만, 제안 프레임워크는 고효율 영역까지 분포가 확장되어 전체적인 균형이 우상단으로 이동하였다. 특히 각 알고리즘의 평균 성능을 나타내는 별 모양의 표식을 비교했을 때, 제안 알고리즘이 가장 우상단에 위치하여 임무 성공과 자원 효율성이라는 두 가지 목표를 동시에 달성하는 최적의 균형점을 찾았음을 나타낸다.
[Table 2]에서는 무인기가 부족 조건의 환경에서 알고리즘 별 세부 평균 점수와 모든 지표를 종합한 총합 점수를 나타낸다. 제안 프레임워크는 자원이 충분한 상황과 마찬가지로 모든 지표를 종합한 총점에서 가장 뛰어난 성능을 달성했다. 특히 자원 부족 상황에서는 임무의 중요성에 따라 무인기를 효율적으로 분배하는 자원 효율성 점수와 실시간으로 변화하는 환경에 얼마나 빨리 반응하고 적응할 수 있는지를 나타내는 지표인 재할당 점수에서의 압도적인 차이가 두드러졌다. 특히 자원 효율성 점수에서 다른 알고리즘 대비 약 40% 이상의 점수 향상을 보였다. 또한 목표물의 중요도 대비 임무 완수율을 나타내는 임무 성공 점수에서도 높은 점수를 나타냈다.
Comparison of average algorithm scores across experiments in scenarios with a low UAV-to-target ratio
[Table 2]의 생존성 지표는 임무 미완수 목표물 대비 운용 가능한 무인기의 비율로서 무인기가 1~2배인 많은 상황에서 임무 성공률 50 %의 무인기가 대부분 생존하기 어려운 환경이다. 따라서 생존성 지표는 모든 알고리즘에서 0에 가까운 점수가 나온 것을 확인할 수 있다.
제안 프레임워크가 자원 부족 상황에서 대부분의 평가지표에서 다른 알고리즘 대비 우수한 결과를 보인 것은 LLM이 상황의 맥락을 이해하고 처리 가능한 임무 효율을 극대화하는 방향으로 전략을 수정했기 때문이다. 기존 알고리즘이 기계적으로 모든 목표물에 자원을 분산시킨 반면, 제안하는 프레임워크는 높은 중요도의 목표물을 선별하여 자원을 집중하는 재할당 전략을 취했다. 결론적으로 제안하는 기법은 무인기의 자원효율성을 극대화하여 자원 제약 상황에서 발생할 수 있는 시스템의 급격한 성능 저하를 방지하고, 임무의 질적 가치를 보존하는 데 효과적임을 확인하였다.
본 절에서는 자원 부족 상황의 특정 시나리오(Exp 4) 상황에서의 대응 결과를 분석한다. 무인기의 임무 성공률이 50 %이므로 무인기의 수가 목표물 수 대비 2배 이하인 자원 제약 상황이다. 4번의 시나리오는 초기 드론 16대, 목표물 11대의 상황이다. 비교 알고리즘들은 적은 수의 무인기를 목표물 모두에게 할당하는 모습을 보였지만, 제안 기법은 초기 할당에서 우선순위가 높은 3개 목표물에게 집중하여 다수의 무인기를 할당하는 모습을 보였다.
[Fig. 5]는 자원 부족의 특정 시나리오(Exp 4)에서 초기 할당 모습(t=5)과 목표물 2대가 추가 탐지된 상태의 동적 이벤트의 발생 순간 (t=15)의 제안 기법의 대응을 보여준다. [Fig. 5]의 가장 오른쪽 그래프의 진한 선은 각 평가지표를 조합한 전체 임무 점수를 나타내며, t=0 초기 상황에는 임무성공점수, 재할당 점수가 0점으로 시작하여 60점부터 시작한다. 자원효율성 점수는 초기 자원할당이 없는 상태에서 패널티가 없는 것으로 간주하여 20점으로 시작한다. 0초부터 시작하는 점선은 각 알고리즘 별 무인기의 수를 의미한다. 세로의 점선은 예측 불가능한 이벤트가 발생하는 t=10, 15 초의 시점을 의미한다. t=15 시점에서 제안 프레임워크는 우선순위가 높은 1, 3 번째의 목표물에 대해 임무를 완수하였고 높은 점수를 획득한 것을 확인할 수 있다. 또한, 중요도가 높은 신규 목표물을 탐지 시 즉각적으로 목표물에게 무인기의 임무를 할당한 모습을 확인할 수 있다.
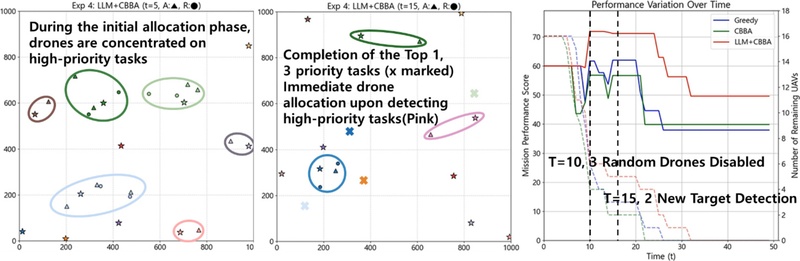
Task allocation of the LLM-CBBA algorithm at scenario 29 (t=5, 15) (★: Target, ▲: Executor, ●: Observer, ×: Completed Target)
비교 알고리즘들은 초기 할당된 여러 대의 목표물에 소수의 무인기를 유지하는 경향을 보인 반면, 제안 프레임워크는 상대적으로 중요도가 떨어지는 임무는 과감히 포기하고 높은 우선순위의 임무를 집중하여 완수한 다음 우선순위로 무인기들을 할당한 결과를 확인할 수 있다.
이는 LLM이 “The new target is assigned higher priority target. Existing high-priority targets have their priorities adjusted to allocate drones efficiently.”처럼 상황의 우선이 되는 임무의 맥락을 파악하고 긴급한 고우선순위의 목표물에게 최적의 자원 분배를 통한 임무 수행을 지시했기 때문이다.
이처럼 제안 프레임워크는 단순한 분산 합의를 넘어, 전략적 의도를 가지고 상황에 적응함으로써 더 높은 임무 성공률과 자원 효율성을 달성하였다.
[Table 3]에서는 각 알고리즘 별 세부 점수와 모든 지표를 종합한 총합 점수를 나타낸다. 결론적으로 본 시나리오의 시뮬레이션에서는 제안 프레임워크가 높은 우선순위의 임무들을 우선적으로 수행하였고, 비교 알고리즘 대비 모든 평가 지표에 대해서 우수한 성능을 보였다.
Comparison of algorithm scores for case study: Experiment 4
6. 결 론
본 연구에서는 군집 무인기 시스템의 예측 불가능한 동적 환경에서 유연하게 대처하지 못하는 기존 알고리즘의 한계를 극복하기 위해, LLM 기반의 전략적 임무 할당 프레임워크를 제안하였다. 제안하는 프레임워크는 자연어로 기술된 전술적 상황과 수치화 된 시스템 상태 사이의 ‘의미론적 간극(Semantic Gap)’을 LLM의 추론 능력으로 연결하고, 이를 통해 최적화 알고리즘 CBBA의 핵심 파라미터를 동적으로 제어하는 하이브리드 프레임워크 구조를 채택하였다.
시뮬레이션 실험 결과 제안기법은 자원이 충분한 일반적인 상황뿐만 아니라 특히 자원 부족 상황과 같은 위기 상황에서 월등한 자원 효율성과 임무 성공률을 보였다. 구체적으로 무인기의 수가 부족하여 모든 임무를 완수할 수 없을 때 제안 프레임워크는 우선순위가 낮은 임무는 과감히 포기하고 우선순위가 높은 임무들에 집중하는 전략적 의사결정을 통해 임무 성공률과 자원 효율성 등의 평가 지표를 높이는 결과를 확인하였다. 이는 단순한 수치 최적화에 매몰되었던 기존 기법들과 달리, LLM이 무인기 군집 제어 시스템의 의사결정권자로서 설명 가능한 전략적 판단을 내릴 수 있음을 입증한 결과이다.
이러한 가능성에도 불구하고, 본 프레임워크를 실제 현장에 즉각 적용하기 위해서는 몇 가지 기술적 과제가 해결되어야 한다. 우선 LLM의 높은 연산 부하로 인한 실시간성 문제를 극복하기 위해, 엣지 디바이스 탑재가 가능한 경량화 모델(sLLM) 기반의 온보드(On-board) 에이전트 연구가 필수적이다. 또한, 통신 단절이나 대역폭 제한이 빈번한 실제 환경을 고려하여, 중앙 집중식 구조를 넘어 에이전트 간 자연어 통신을 통한 분산형 의사결정 체계로의 확장이 요구된다.
현재 시뮬레이션 환경이 모든 상황에서 임무 성공 확률을 50%로 고정하는 등의 환경적 제약이 단순하게 반영되었다는 한계가 있다. 이러한 시뮬레이션 환경 설정은 LLM이 결정하는 무인기와 목표물의 할당 효율성을 비교하는 데에는 적합하나, 환경 맥락에 따라 의사결정을 어떻게 달리 하는지를 평가하기에는 충분하지 않다. 현실의 임무 환경에서는 지형지물에 제약되는 공간적 특성에 따라 목표물의 이동 방향이나 통신 및 탐지 실패 확률 등이 변화할 수 있다. 향후 연구에서는 현실적인 환경 요인들을 LLM의 입력 맥락으로 확장하여 포함함으로써 환경 인식 기반의 전략적 의사결정이 가능한 보다 정교한 평가 체계를 구축할 계획이다. 이를 통해 복잡한 환경 맥락을 인지한 상태에서의 의사결정 능력을 심층적으로 분석하고, 본 프레임워크가 제시하는 전략적 의사결정의 타당성과 해석 가능성을 한층 더 명확하게 검증할 수 있을 것으로 기대된다. 나아가 텍스트 변환 과정에서 발생할 수 있는 정보 손실을 최소화하기 위해 시각 정보를 직접 해석하는 멀티모달 접근법을 도입하고, 실제 소형 드론 군집을 활용한 실험을 통해 시뮬레이션과 현실 간의 간극(Sim-to-Real Gap)을 좁혀 나갈 계획이다.
본 연구는 향후 복잡한 재난이나 구조 현장에서 사람 개입을 최소화하면서도 인간의 의도를 정확히 반영하는 자율 임무 수행 시스템 구축에 기여할 것으로 기대된다.
Acknowledgments
This work was supported by the Korean Government.
References
-
M. Rinaldi, S. Wang, R. S. Geronel, and S. Primatesta, “Application of task allocation algorithms in multi-UAV intelligent transportation systems: A critical review,” Big Data and Cognitive Computing, vol. 8, no. 12, Art. no. 177, Dec., 2024.
[https://doi.org/10.3390/bdcc8120177]

-
B. P. Gerkey and M. J. Matarić, “A formal analysis and taxonomy of task allocation in multi-robot systems,” The International Journal of Robotics Research, vol. 23, no. 9, pp. 939-954, Sep., 2004.
[https://doi.org/10.1177/0278364904045564]
-
G. A. Korsah, A. Stentz, and M. B. Dias, “A comprehensive taxonomy for multi-robot task allocation,” The International Journal of Robotics Research, vol. 32, no. 12, pp. 1495-1512, Oct., 2013.
[https://doi.org/10.1177/0278364913496484]
-
H.-L. Choi, L. Brunet, and J. P. How, “Consensus-based decentralized auctions for robust task allocation,” IEEE Transactions on Robotics, vol. 25, no. 4, pp. 912-926, Aug., 2009.
[https://doi.org/10.1109/TRO.2009.2022423]
-
P. Li, Z. An, S. Abrar, and L. Zhou, “Large language models for multi-robot systems: A survey,” Autonomous Robots, vol. 50, no. 3, article. 30, Jun., 2026.
[https://doi.org/10.1007/s10514-026-10257-4]
-
N. Atay and B. Bayazit, “Mixed-integer linear programming solution to multi-robot task allocation problem,” Department of Computer Science and Engineering, Washington University in St. Louis, St. Louis, MO, USA, Tech. Rep. WUCSE-2006-54, 2006.
[https://doi.org/10.7936/K7R49P04]
-
Z. Wang, J. Zhao, H. Deng, C. Xing, and T. Gao, “Heterogeneous multi-UAV multi-task reallocation problem using mixed-integer linear programing,” in Proceedings of 2021 International Conference on Autonomous Unmanned Systems (ICAUS 2021), Singapore, 2022, pp. 3453-3459.
[https://doi.org/10.1007/978-981-16-9492-9_340]
-
J. G. Martin, J. R. D. Frejo, R. A. García, and E. F. Camacho, “Multi-robot task allocation problem with multiple nonlinear criteria using branch and bound and genetic algorithms,” Intelligent Service Robotics, vol. 14, no. 5, pp. 707-727, Nov., 2021.
[https://doi.org/10.1007/s11370-021-00393-4]
-
C. Wei, Z. Ji, and B. Cai, “Particle swarm optimization for cooperative multi-robot task allocation: A multi-objective approach,” IEEE Robotics and Automation Letters, vol. 5, no. 2, pp. 2530-2537, Apr., 2020.
[https://doi.org/10.1109/LRA.2020.2972894]
-
N. Buckman, J. P. How, and H.-L. Choi, “Partial replanning for decentralized dynamic task allocation,” in AIAA Scitech 2019 Forum, San Diego, CA, USA, Jan., 2019, Art. no. AIAA 2019-0915.
[https://doi.org/10.2514/6.2019-0915]
-
J. Chen, X. Qing, F. Ye, K. Xiao, K. You, and Q. Sun, “Consensus-based bundle algorithm with local replanning for heterogeneous multi-UAV system in the time-sensitive and dynamic environment,” The Journal of Supercomputing, vol. 78, no. 2, pp. 1712–1740, Feb., 2022.
[https://doi.org/10.1007/s11227-021-03940-z]
-
D. Liu, L. Dou, R. Zhang, X. Zhang, and Q. Zong, “Multi-agent reinforcement learning-based coordinated dynamic task allocation for heterogenous UAVs,” IEEE Transactions on Vehicular Technology, vol. 72, no. 4, pp. 4372-4383, Apr., 2023.
[https://doi.org/10.1109/TVT.2022.3228198]
-
Y. Zhang, G. Yi, H. Wang, Y. Cheng, Y. Chen, and Z. Wei, “LLMGA: A large language model-guided genetic algorithm for dynamic parameter control in multi-UAV target assignment,” in 2025 44th Chinese Control Conference (CCC), Chongqing, China, Jul., 2025, pp. 2063–2068.
[https://doi.org/10.23919/CCC64809.2025.11178839]
-
H. Wang, S. Xue, H. Zhang, L. Tan, C. Wang, and Y. Fu, “Dynamic multi-robot task allocation for human-in-the-loop space exploration: Knowledge graph-guided CBBA with LLM-assisted fault analysis,” Machines, vol. 14, no. 3, Art. no. 265, Feb., 2026.
[https://doi.org/10.3390/machines14030265]
-
P. Jaccard, “Étude comparative de la distribution florale dans une portion des Alpes et du Jura,” Bulletin de la Société Vaudoise des Sciences Naturelles, vol. 37, no. 142, pp. 547-579, 1901.
[https://doi.org/10.5169/seals-266450]
-
A. H. Liu et al., “Ministral 3,” arXiv preprint arXiv:2601.08584, Jan., 2026.
[https://doi.org/10.48550/arXiv.2601.08584]
-
D. Guo et al., “DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning,” arXiv preprint arXiv:2501.12948, Jan., 2025.
[https://doi.org/10.48550/arXiv.2501.12948]
-
A. Yang et al., “Qwen3 technical report,” arXiv preprint arXiv:2505.09388, May., 2025.
[https://doi.org/10.48550/arXiv.2505.09388]
-
A. Grattafiori et al., “The Llama 3 herd of models,” arXiv preprint arXiv:2407.21783, Jul., 2024.
[https://doi.org/10.48550/arXiv.2407.21783]
-
G. Comanici et al., “Gemini 2.5: Pushing the frontier with advanced reasoning, multimodality, long context, and next generation agentic capabilities,” arXiv preprint arXiv:2507.06261, Jul., 2025.
[https://doi.org/10.48550/arXiv.2507.06261]
2021 충남대학교 항공우주공학과(학사)
2023 광주과학기술원 기계공학부(석사)
2024~현재 국방과학연구소 국방인공지능 기술연구원 연구원
관심분야: Robotics, Multi-Agent System, Reinforcement Learning